

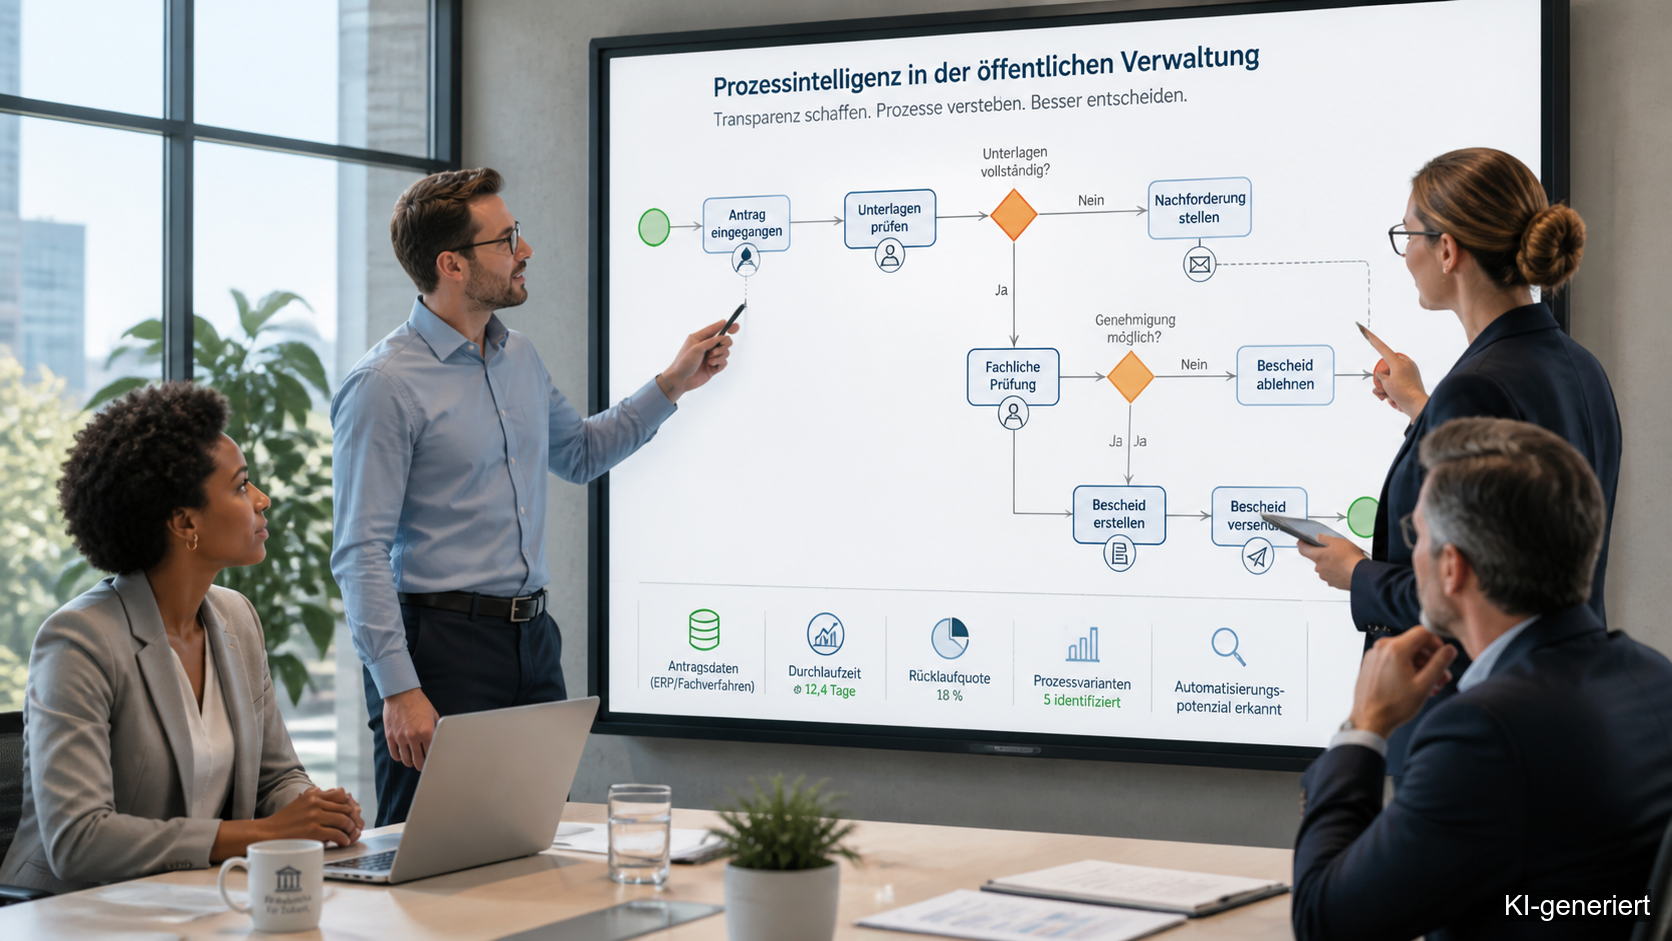
Einordnung: Prozessintelligenz als Teil des BPM-Lebenszyklus
Prozessintelligenz beschreibt die datenbasierte Analyse, Steuerung und kontinuierliche Verbesserung von Geschäftsprozessen. Sie verbindet klassische Business Process Management (BPM)-Ansätze mit datengetriebenen Methoden wie Process Mining und Decision Analytics (Dumas et al., 2018; van der Aalst, 2016).
Im BPM-Lebenszyklus (Identifikation, Modellierung, Implementierung, Monitoring, Optimierung) adressiert Prozessintelligenz insbesondere die Phasen Monitoring und Optimierung und schließt damit die Lücke zwischen Modell und tatsächlicher Ausführung (Dumas et al., 2018).
Entscheidend ist: Prozessintelligenz ist kein Großprojekt, sondern ein iterativer Verbesserungsansatz im Sinne eines evidenzbasierten Managements.
Schritt 1: Auswahl eines geeigneten Startprozesses
Aus wirtschaftsinformatischer Perspektive handelt es sich um ein Problem-Fit-Thema: Nicht jeder Prozess bietet ausreichend Daten, Standardisierung oder Wirkungspotenzial.
- Hohe Fallzahlen (statistische Auswertbarkeit, Skaleneffekte)
- Geringe Varianz (Standardisierbarkeit, Automatisierungspotenzial)
- Klare Entscheidungslogiken (Formaliserbarkeit in DMN)
- Hohe operative Relevanz (sichtbarer Nutzen für Stakeholder)
Diese Kriterien entsprechen dem Prinzip der zielgerichteten Artefaktauswahl im Design Science Research (Hevner et al., 2004).
Schritt 2: Ist-Prozess als sozio-technisches System erfassen
Der Ist-Prozess ist nicht nur eine Abfolge von Aktivitäten, sondern ein sozio-technisches System aus Menschen, Technologien, Daten und Regeln.
- Menschen (Sachbearbeiter, Entscheidungspraktiken)
- Technologien (Fachverfahren, Schnittstellen)
- Daten (Formulare, Registerzugriffe)
- Regeln (Gesetze, Verwaltungsvorschriften)
Die Erhebung erfolgt typischerweise qualitativ (Workshops), ergänzt durch erste Datenanalysen, etwa zu Durchlaufzeiten.
Ziel ist ein „as-is“-Modell, das sowohl die formale Struktur (BPMN) als auch die gelebte Praxis (Workarounds, informelle Regeln) abbildet.
Schritt 3: Schwachstellenanalyse als datengetriebene Diagnose
Die Identifikation von Schwachstellen kann entlang typischer BPM-Antipatterns systematisiert werden (van der Aalst, 2016).
- Wartezeiten (Queueing-Probleme, fehlende Priorisierung)
- Redundanzen (fehlende Prozessintegration)
- Medienbrüche (mangelnde Systemkopplung)
- Entscheidungsinkonsistenzen (fehlende Formalisierung)
- Routingfehler (fehlende Workflow-Logik)
Aus wirtschaftsinformatischer Sicht sind diese Probleme häufig daten- und systembedingt und nicht ausschließlich organisatorisch erklärbar.
Schritt 4: Soll-Prozess als Design-Artefakt
Der Soll-Prozess stellt ein Artefakt im Sinne der Design Science dar und integriert Prozess-, Entscheidungs- und Datenlogik (Hevner et al., 2004).
- Prozesslogik (BPMN)
- Entscheidungslogik (DMN)
- Datenstruktur (FIM, Registermodelle)
Zentrale Gestaltungsprinzipien sind:
- Explizite Entscheidungsmodellierung zur Erhöhung von Transparenz und Automatisierbarkeit
- Standardisierung von Daten als Grundlage für Interoperabilität
- Automatisierung von Standardfällen im Sinne von Straight-Through Processing
- Gezielte Eskalation von Ausnahmefällen (Human-in-the-Loop)
Schritt 5: Pilotierung als Evaluation
Die Pilotphase entspricht der Evaluation im Design Science Research und dient der Validierung des entwickelten Artefakts (Hevner et al., 2004).
- Validierung der Funktionalität
- Bewertung der Zielerreichung (Zeit, Qualität)
- Analyse unerwarteter Effekte
Typische Messgrößen umfassen Durchlaufzeiten, Fehlerquoten, Prozessvarianz sowie Nutzerakzeptanz.
Schritt 6: Skalierung und datengetriebenes Prozessmanagement
Nach erfolgreicher Pilotierung erfolgt die Überführung in ein kontinuierliches Prozessmanagement im Sinne eines Closed-Loop-BPM (Dumas et al., 2018).
Process Mining übernimmt dabei eine zentrale Rolle als Monitoring-, Analyse- und Steuerungsinstrument (van der Aalst, 2016).
- Erkennung von Soll-Ist-Abweichungen
- Identifikation von Engpässen und Varianten
- Datenbasierte Entscheidungsunterstützung
Ergänzend sind Governance-Strukturen erforderlich:
- Process Owner (Prozessverantwortung)
- Data Owner (Datenverantwortung)
- Decision Owner (Verantwortung für Entscheidungslogiken)
Architekturperspektive: Integration statt Insellösungen
Prozessintelligenz entfaltet ihren Nutzen nur innerhalb einer konsistenten IT-Architektur.
- Integration von Fachverfahren über Schnittstellen (APIs, XÖV-Standards)
- Nutzung zentraler Register im Sinne des Once-Only-Prinzips
- Konsistente Datenmodelle als Grundlage (z. B. FIM)
Ohne diese Integration bleiben Optimierungen lokal und nicht skalierbar.
Fallbeispiel: Gewerbeanmeldung als Minimal Viable Transformation
Eine Stadt mit etwa 80.000 Einwohnern reduzierte die Bearbeitungszeit einer Gewerbeanmeldung von 14 auf 4 Arbeitstage.
Aus wirtschaftsinformatischer Sicht waren folgende Maßnahmen entscheidend:
- Eliminierung redundanter Prüfungen (Prozessintegration)
- Einführung klarer Entscheidungsregeln (DMN)
- Automatisiertes Routing (Workflow-Logik)
- Reduktion von Medienbrüchen (End-to-End-Digitalisierung)
Die Verbesserung wurde primär durch Prozess-Redesign erreicht, nicht durch zusätzliche Technologie.
Fazit: Prozessintelligenz als evidenzbasierte Verwaltungsmodernisierung
Prozessintelligenz ist ein Managementansatz, der Prozessmodellierung, Entscheidungsmodellierung, Datenstandardisierung und datengetriebene Analyse integriert.
Der Einstieg erfolgt pragmatisch, die Wirkung entsteht durch systematische Skalierung und kontinuierliche Verbesserung.
Weiterführende Beiträge
- Prozessmanagement-Reife: Wo steht Ihre Behörde – und was kommt als Nächstes?
- Process Mining in der öffentlichen Verwaltung: Prozesse datenbasiert verstehen
- Was ist BPMN – und warum braucht die Verwaltung diese Methode?
Literatur
- Dumas, M., La Rosa, M., Mendling, J., & Reijers, H. A. (2018). Fundamentals of Business Process Management (2nd ed.). Springer. https://doi.org/10.1007/978-3-662-56509-4
- van der Aalst, W. M. P. (2016). Process Mining: Data Science in Action (2nd ed.). Springer. https://doi.org/10.1007/978-3-662-49851-4
- Hevner, A. R., March, S. T., Park, J., & Ram, S. (2004). Design science in information systems research. MIS Quarterly, 28(1), 75–105. https://doi.org/10.2307/25148625
